Khoa Công nghệ thông tin xin gửi lời chúc mừng đến nhóm sinh viên do GS. TS. Lê Hoài Bắc hướng dẫn đã có hai công bố tại Hội nghị uy tín quốc tế rank A.
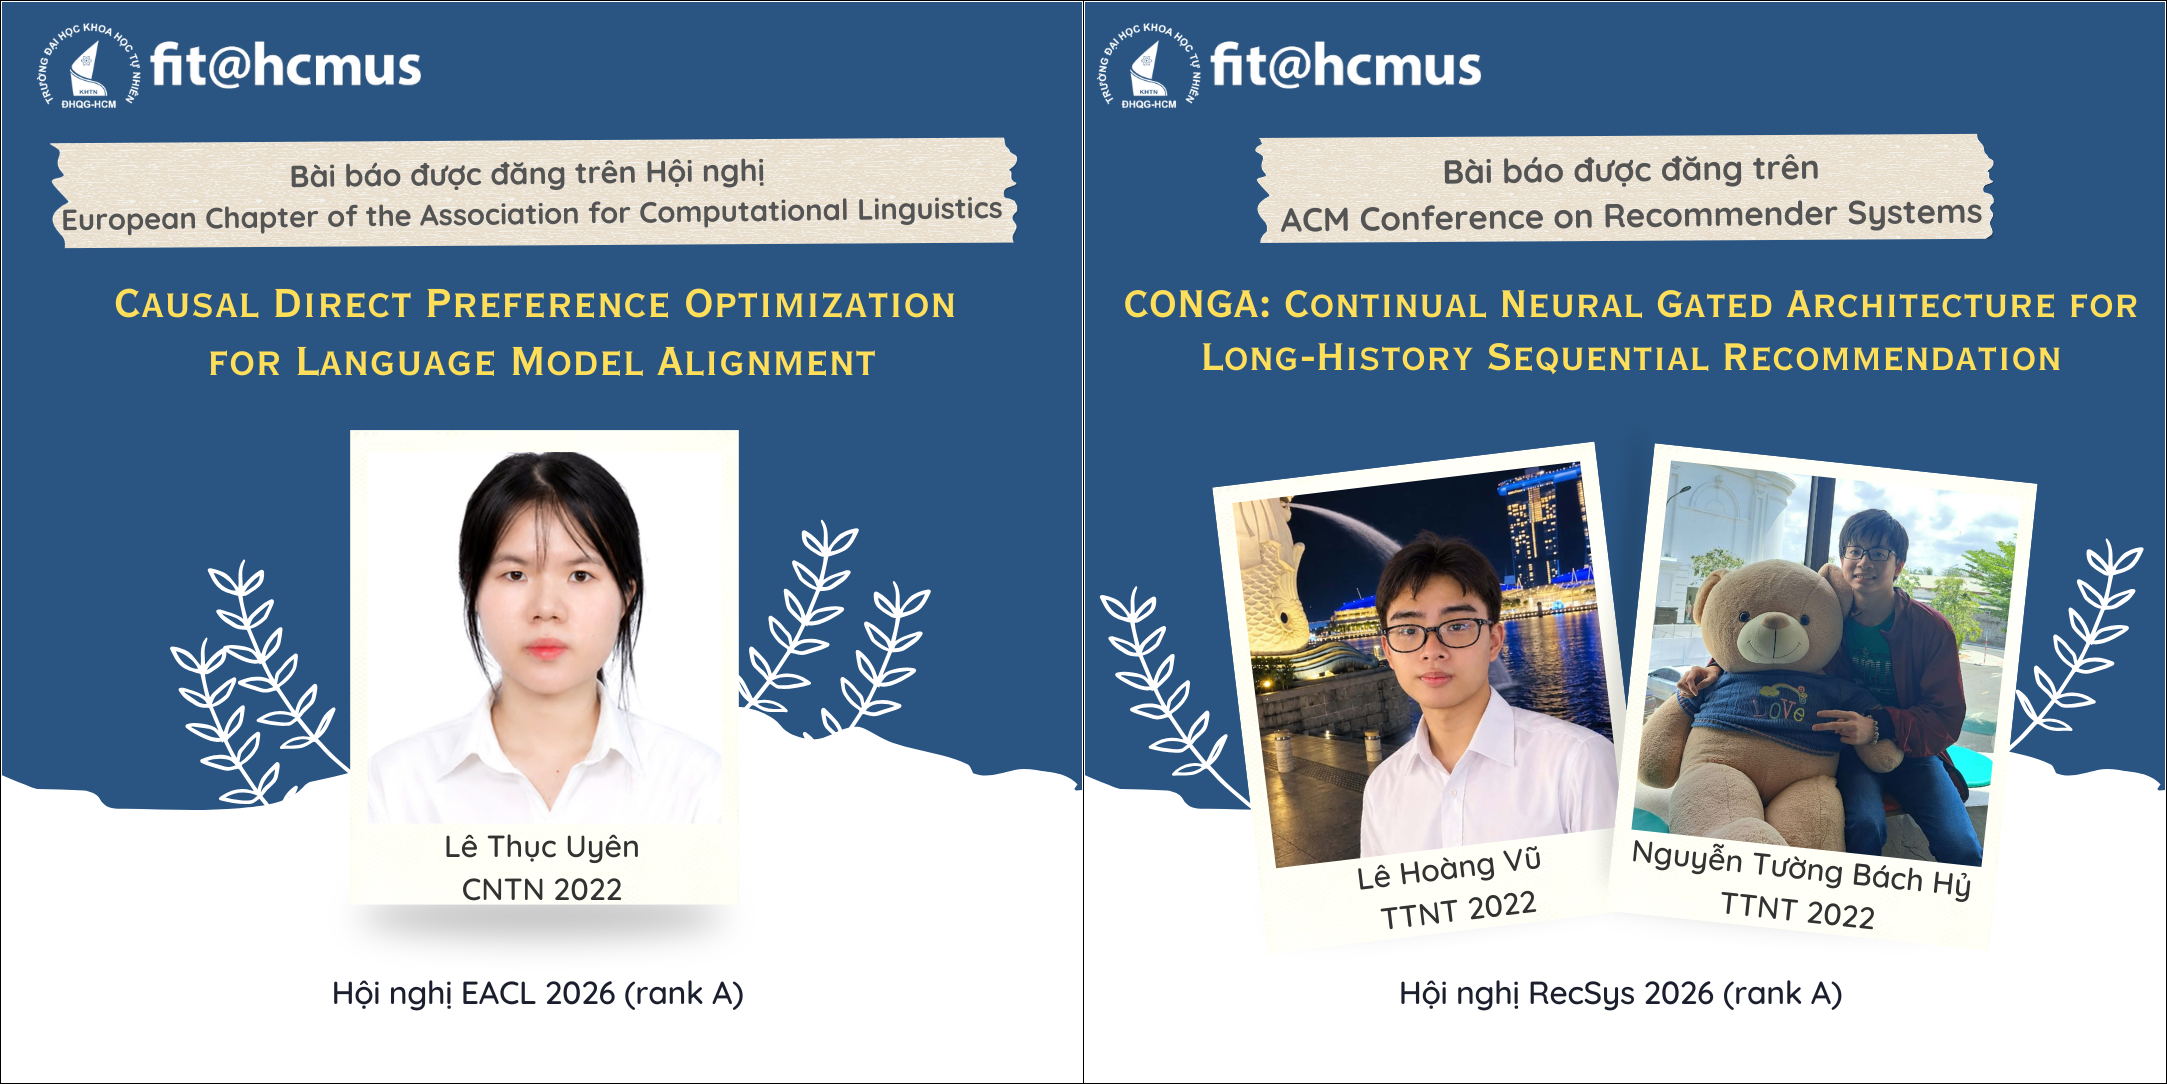
🌟 Bài báo số 1: Causal Direct Preference Optimization for Language Model Alignment
👉 Link bài báo https://aclanthology.org/2026.findings-eacl.58/
 Các tác giả: Uyen Le, Thin Nguyen, Toan Nguyen, Toan Doan, Trung Le, Bac Le
Tác giả đầu: SV. Lê Thục Uyên, sinh viên Cử nhân tài năng, khóa tuyển 2022
Giảng viên cùng thực hiện: GS. TS. Lê Hoài Bắc – Giảng viên Khoa Công nghệ Thông tin, Trường Đại học Khoa học tự nhiên, ĐHQG-HCM
🔥 Tóm tắt bài báo: Direct Preference Optimization (DPO) là một phương pháp mạnh mẽ để căn chỉnh các mô hình ngôn ngữ lớn (LLM) với sở thích của con người bằng cách chuyển bài toán học sở thích thành một bài toán phân loại có giám sát trên các đầu ra được con người gán nhãn theo từng cặp, từ đó cho phép quá trình huấn luyện ổn định và hiệu quả. Chúng tôi chỉ ra rằng DPO kế thừa các sai lệch từ các biến gây nhiễu (confounder), chẳng hạn như chủ đề, phong cách và mục tiêu của người dùng, vốn ảnh hưởng đến quá trình tạo dữ liệu và tiếp tục được truyền vào quá trình huấn luyện, từ đó cản trở việc khôi phục sở thích thực sự của con người.Để giải quyết vấn đề này dưới góc nhìn nhân quả, chúng tôi đề xuất Causal Direct Preference Optimization (CDPO), một khuôn khổ tổng quát áp dụng các nguyên lý của suy luận nhân quả nhằm giảm thiểu ảnh hưởng của các biến gây nhiễu và làm nổi bật hơn tín hiệu phản ánh sở thích thực sự của con người. Phương pháp của chúng tôi vẫn giữ được tính đơn giản và khả năng tối ưu trực tiếp của DPO, đồng thời tăng khả năng chống lại các tương quan giả và sai lệch trong quá trình gán nhãn.Các đánh giá thực nghiệm trên những bộ dữ liệu chuẩn cho thấy CDPO vượt trội hơn các phương pháp baseline dựa trên DPO, đạt được quá trình fine-tuning ít bị ảnh hưởng bởi sai lệch thông qua suy luận nhân quả, qua đó khẳng định hiệu quả của phương pháp tối ưu hóa sở thích có xét đến các biến gây nhiễu.
✨ Điểm nổi bật của bài báo: Bài báo nổi bật ở việc chỉ ra rằng DPO có thể bị ảnh hưởng bởi các yếu tố gây nhiễu (confounders), khiến mô hình học cả những thiên lệch thay vì sở thích thực sự của con người. Từ đó, bài báo đề xuất CDPO , sử dụng học nhân quả và điều chỉnh backdoor để giảm ảnh hưởng này, đồng thời vẫn giữ được sự đơn giản của DPO, không cần mô hình phần thưởng hay học tăng cường. Kết quả thực nghiệm cho thấy CDPO hoạt động tốt hơn DPO và β-DPO trên các bộ dữ liệu được đánh giá.
🌈 Về Hội nghị European Chapter of the Association for Computational Linguistics: EACL là một hội nghị quốc tế uy tín về Xử lý Ngôn ngữ Tự nhiên (NLP) và Ngôn ngữ học tính toán, thuộc cộng đồng Association for Computational Linguistics (ACL). EACL được xếp hạng A theo ICORE2026. EACL 2026 là lần tổ chức thứ 19, diễn ra từ ngày 24 đến 29 tháng 3 năm 2026 tại Rabat, Morocco. Hội nghị tập trung vào các nghiên cứu mới về NLP, ngôn ngữ học tính toán và các lĩnh vực liên quan, với sự tham gia của các nhà nghiên cứu quốc tế. EACL được xếp hạng A theo ICORE2026, thuộc nhóm các hội nghị có uy tín cao trong lĩnh vực NLP. Hội nghị tập trung vào các nghiên cứu mới về NLP, ngôn ngữ học tính toán và Large Language Models (LLMs), với sự tham gia của các nhà nghiên cứu đến từ nhiều quốc gia trên thế giới.
🌟 Bài báo số 2: CONGA: Continual Neural Gated Architecture for Long-HistorySequential Recommendation
👉 Link bài báo: https://drive.google.com/file/d/1bxZix8g89dKs7e93Jv2Ct-D7y_Alzycd/view
 Các tác giả của bài báo: Hoang-Vu Le, Tuong-Bach-Hy Nguyen, Bac Le
Thông tin tác giả: SV. Lê Hoàng Vũ và SV. Nguyễn Tường Bách Hỷ, sinh viên Trí tuệ nhân tạo, khóa tuyển 2022
Giảng viên cùng thực hiện: GS. TS. Lê Hoài Bắc – Giảng viên Khoa Công nghệ Thông tin, Trường Đại học Khoa học tự nhiên, ĐHQG-HCM
🔥 Tóm tắt bài báo: Các mô hình gợi ý tuần tự hiện nay dựa trên mã hóa vị trí tuyệt đối và cửa sổ ngữ cảnh cố định, dẫn đến hai chế độ lỗi cấu trúc: suy giảm biểu diễn khi lịch sử kiểm tra dài hơn lịch sử huấn luyện (out-of-distribution), và giới hạn cứng về ngữ cảnh khiến các tương tác xa bị loại bỏ. Bài báo đề xuất CONGA, giải quyết đồng thời hai hạn chế trên qua ba đóng góp: (1) Rotary Positional Embeddings (RoPE) với tính chất bảo toàn chuẩn, được tăng tốc bằng CUDA kernel tùy chỉnh; (2) hợp nhất đa luồng KromHC với cơ chế trộn doubly-stochastic chính xác dựng từ tích Kronecker, cùng cơ chế chọn số luồng thích nghi theo mật độ dữ liệu để tránh overfitting trên corpus thưa; (3) bộ nhớ liên kết nơ-ron TITANS được thích ứng cho gợi ý item rời rạc qua giao thức huấn luyện hai pha có tính chất phòng tránh quên mang tính cấu trúc. Đánh giá dưới giao thức full-ranking nghiêm ngặt trên bốn benchmark, CONGA đạt kết quả tốt nhất trên các benchmark lịch sử dài, với mức tăng tới +18,7% HR@5 trên ML-1M, đồng thời duy trì cải thiện nhất quán trên các tập dữ liệu lịch sử ngắn.
✨ Điểm nổi bật của bài báo: Trên nhóm người dùng khó nhất - có lịch sử tương tác dài, nơi các mô hình gợi ý hiện nay suy giảm chất lượng rõ nhất - CONGA cải thiện +18,72% HR@5 và +18,77% NDCG@10 so với baseline mạnh nhất trên ML-1M, dẫn đầu 14/16 chỉ số trên bốn benchmark chuẩn dưới giao thức full-ranking (chấm điểm trên toàn bộ catalog, không lấy mẫu - khắt khe hơn cách đánh giá phổ biến hiện nay). Kết quả đến từ việc đưa bộ nhớ liên kết nơ-ron kiểu TITANS vào bài toán gợi ý với item ID rời rạc - hướng đi mà theo khảo sát của nhóm chưa từng được thử nghiệm trước đó - kết hợp giao thức huấn luyện hai pha giúp mô hình tiếp nhận dữ liệu mới mà không quên những gì đã học. Bốn CUDA kernel tự viết giúp huấn luyện nhanh hơn khoảng 10 lần, đưa thời gian huấn luyện toàn bộ mô hình xuống dưới 5 giờ.
🌈 Về Hội nghị RecSys 2026 (ACM Conference on Recommender Systems): Là hội nghị quốc tế hàng đầu thế giới về hệ thống gợi ý (recommender systems), được ACM (Association for Computing Machinery) tổ chức thường niên từ năm 2007; RecSys 2026 là kỳ tổ chức lần thứ 20, diễn ra từ 28/9 đến 2/10/2026 tại Minneapolis, Minnesota, Hoa Kỳ. Hội nghị được xếp hạng Core Rank A với tỉ lệ chấp nhận bài báo dài hằng năm chỉ khoảng 16–20% (năm nay là 18%); quy tụ các nhà nghiên cứu và kỹ sư hàng đầu trong lĩnh vực học máy, khai thác dữ liệu và cá nhân hóa.
🌻 Xin chúc mừng nhóm tác giả với những thành tựu nghiên cứu xuất sắc này.
🌻Chúc các bạn sẽ tiếp tục đạt được thành công trong tương lai.