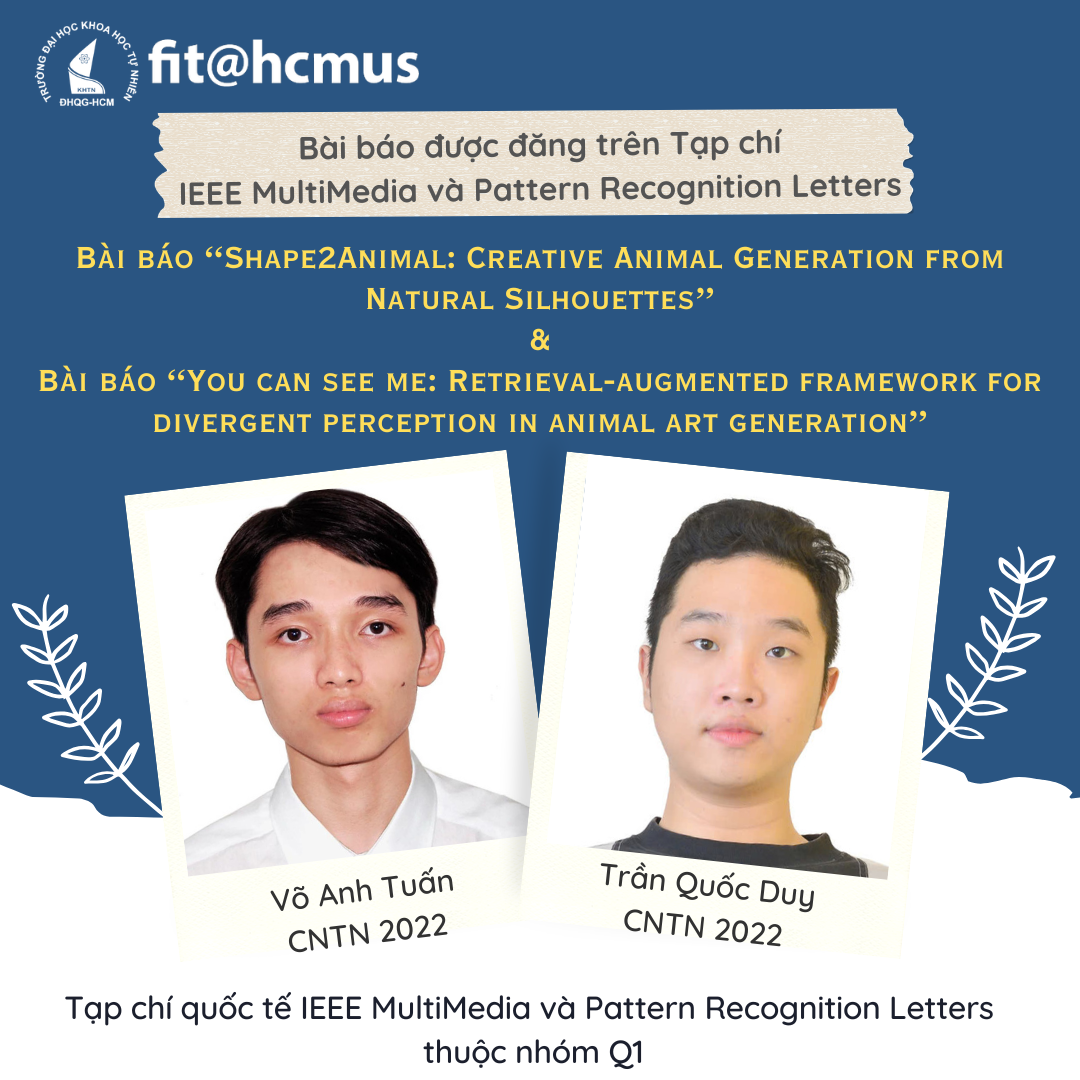
Khoa Công nghệ thông tin xin gửi lời chúc mừng đến bạn Trần Quốc Duy và bạn Võ Anh Tuấn - nhóm Sinh viên Cử nhân tài năng, khoá tuyển 2022 - đã có hai công bố tại Tạp chí uy tín quốc tế Q1.
🌟 Bài báo số 1: Shape2Animal: Creative Animal Generation from Natural Silhouettes
👉Link bài báo: 1: https://www.computer.org/csdl/magazine/mu/5555/01/11666939/2jgNkDrpVYc
 Các tác giả: Quoc-Duy Tran, Anh-Tuan Vo, Dinh-Khoi Vo, Tam V. Nguyen, Minh-Triet Tran, and Trung-Nghia Le
🔥 Tóm tắt bài báo: Shape2Animal là framework tự động hoàn toàn để biến hình bóng vật thể tự nhiên thành hình động vật hợp lý. Khác với Visual-RAG, hệ thống này không truy hồi mà dùng VLM Gemini 2.5 để "nhìn" mask và trực tiếp đề xuất tên động vật cùng prompt mô tả chi tiết (ví dụ "sea turtle với mai xanh-nâu, chân chèo ở góc dưới phải"). Ảnh được sinh bằng Stable Diffusion XL inpainting có ControlNet-depth (bản đồ độ sâu từ MiDaS 3.1, α ≈ 0.999–1.0) để giữ bố cục cảnh, rồi blend 50% với ảnh gốc. Đánh giá trên 62 ảnh (đá, mây, lửa), so sánh với GPT-4o, Gemini Pro, Grok dùng prompt "zero-drift". Khảo sát 39 người cho thấy Shape2Animal dẫn đầu về Shape Preservation (3,86) và Creative Pareidolia (3,74), trong khi GPT-4o thắng về độ chân thực và blend. IoU của Shape2Animal đạt 0,850 so với 0,730 của GPT.
✨ Điểm nổi bật của bài báo: Bài báo làm rõ một trade-off cốt lõi: các mô hình đa dụng ưu tiên độ chân thực nhưng "tràn" ra ngoài hình bóng dù được yêu cầu rõ ràng, chứng minh ràng buộc ở mức prompt là không đủ và cần ràng buộc kiến trúc. Thiết kế đánh giá khá toàn diện với ba lớp: IoU khách quan, khảo sát người (N=39, ~14.580 điểm đánh giá, có ANOVA và phân tích nhóm chuyên môn), và AI evaluator (Claude Sonnet 4.6). Phát hiện thú vị nhất là AI evaluator lại thiên về baseline trên mọi tiêu chí, kể cả Creative Pareidolia — gợi ý rằng VLM khi làm giám khảo có thể mang "thiên kiến photorealism" và đánh giá thấp yếu tố bám hình vốn là cốt lõi của pareidolia. Nghiên cứu sơ bộ về mô-đun diễn giải (22,63% khớp tên tự do, 49,67% được xem là hợp lý) cũng là điểm cộng về tính minh bạch.
🌈 Về Tạp chí IEEE MultiMedia: Tạp chí khoa học của IEEE Computer Society, xuất bản từ năm 1994, chuyên về các công nghệ đa phương tiện (xử lý ảnh/video/âm thanh, truy hồi thông tin đa phương tiện, tương tác người–máy, AI ứng dụng trong multimedia). Tạp chí phát hành theo quý, năm 2025 đăng 68 bài; pISSN 1070-986X, eISSN 1941-0166; CiteScore 7.7, SNIP 1.6 và xếp hạng SJR Q1. Chỉ số Impact Factor mới nhất (JCR công bố tháng 6/2026, dựa trên dữ liệu trích dẫn 2025) là 3.0, thuộc JCR Q2. Đây là tạp chí dạng magazine của IEEE, chú trọng bài có tính ứng dụng, tổng quan và dễ tiếp cận với cộng đồng rộng hơn so với IEEE Transactions on Multimedia.
🌟 Bài báo số 2: You can see me: Retrieval-augmented framework for divergent perception in animal art generation
👉 Link bài báo: https://www.sciencedirect.com/science/article/abs/pii/S0167865526002138?via%3Dihub
Các tác giả của bài báo: Quoc-Duy Tran, Anh-Tuan Vo, Tam V. Nguyen, Minh-Triet Tran, and Trung-Nghia Le
🔥 Tóm tắt bài báo: Đây là bản mở rộng của bài báo đăng tại Hội nghị SoICT 2025 “Visual Retrieval-Augmented Generation for Silhouette-Guided Animal Art” (Link bài SoICT: https://link.springer.com/chapter/10.1007/978-981-92-2584-2_35), đề xuất framework SEEME với hai chiến lược song song: Visual-RAG (giữ nguyên từ bài hội nghị) và Semantic-RAG mới. Semantic-RAG truy hồi top-30 hình dạng tương tự rồi bỏ phiếu có trọng số theo hàm mũ (wᵢ = e^(-sᵢ)) để suy ra lớp động vật, đồng thời phân rã hình bóng bằng convexity-defect (ngưỡng τ = 0,2) thành "shape blueprint" — mô tả có cấu trúc gồm vị trí, hình dạng, kích cỡ từng bộ phận. Blueprint và tên lớp được đưa vào Llama-3-8B-Instruct (temperature 0, JSON schema cố định) để sinh prompt nghệ thuật, rồi Stable Diffusion 1.5 inpainting với Canny ControlNet tạo ảnh. Trên 40 ảnh đầu vào, Semantic-RAG đạt điểm cao nhất trong khảo sát 49 người ở cả bốn tiêu chí (Overall 3,46 so với 3,35 của Shape2Animal và 2,79 của Visual-RAG), với kiểm định Wilcoxon p < 0,001.
✨ Điểm nổi bật của bài báo: Đóng góp nổi bật là mô hình "symbolic-neural": tách phần suy luận hình học (mô tả cổ điển, có thể kiểm tra bằng mắt người) khỏi phần tổng hợp ngữ nghĩa (LLM), hoàn toàn training-free. Cách này vừa diễn giải được, vừa rẻ hơn dùng VLM độc quyền như GPT-5, và ổn định hơn VLM nhỏ như InternVL3-2B. Ablation Semantic-RAG-β (chỉ dùng top-1) cho thấy bỏ phiếu đa ứng viên rất quan trọng với các hình bất định như mây và lửa, đồng thời khắc phục điểm yếu của Visual-RAG khi truy hồi được mask không hoàn chỉnh. Bài báo cũng thẳng thắn về chi phí: SC matching chiếm ~116s/truy vấn (>93% thời gian), và Krippendorff's α rất thấp (0,09–0,20) phản ánh tính chủ quan cao của đánh giá sáng tạo. Phần thảo luận thất bại chia theo ba giai đoạn (truy hồi, phân tích cấu trúc, tổng hợp) kèm hướng khắc phục cụ thể là điểm mạnh về mặt học thuật.
🌈 Về Tạp chí Pattern Recognition Letters: Tạp chí khoa học được bình duyệt, do North Holland (thuộc Elsevier) xuất bản thay mặt Hiệp hội Nhận dạng mẫu quốc tế IAPR, phát hành 16 số/năm, ra đời từ năm 1982. Tạp chí hướng tới xuất bản nhanh các bài báo ngắn gọn về nhận dạng mẫu, bao trùm mọi lĩnh vực mà các Ủy ban kỹ thuật của IAPR quan tâm cùng các chủ đề mới về học máy và nhận dạng. Impact Factor 2025 là 3.3, IF 5 năm là 4.0, thuộc JCR Q2; CiteScore 8.6, SNIP 1.79 và xếp hạng SJR Q1; năm 2025 đăng 314 bài. Là tạp chí lâu đời, uy tín trong cộng đồng nhận dạng mẫu và thị giác máy tính, phù hợp với các bài báo cô đọng, công bố nhanh.
🌻 Xin chúc mừng nhóm tác giả với những thành tựu nghiên cứu xuất sắc này.
🌻Chúc các bạn sẽ tiếp tục đạt được thành công trong tương lai.