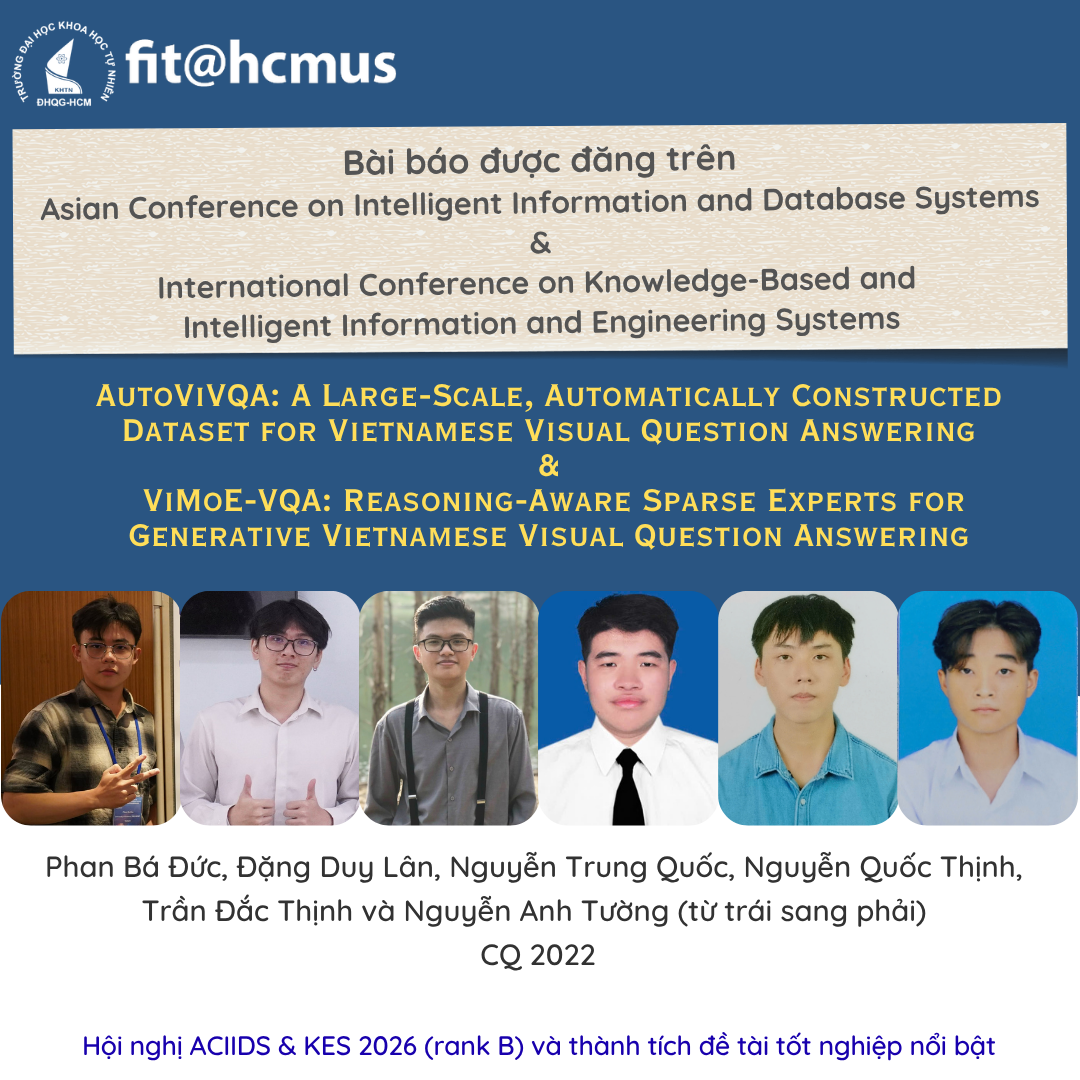
Khoa Công nghệ thông tin xin gửi lời chúc mừng đến các nhóm Sinh viên chương trình Chính quy do TS. Lê Thanh Tùng hướng dẫn đã có đề tài khóa luận xuất sắc cùng với các công bố trên Hội nghị uy tín quốc tế rank B.
🌟 Bài báo số 1: AutoViVQA: A Large-Scale, Automatically Constructed Dataset for Vietnamese Visual Question Answering
👉 Link bài báo https://link.springer.com/chapter/10.1007/978-981-92-0068-9_33
 Các tác giả: SV. Nguyễn Anh Tường, SV. Phan Bá Đức, SV. Nguyễn Trung Quốc, SV. Trần Đắc Thịnh, SV. Đặng Duy Lân, SV. Nguyễn Quốc Thịnh - Sinh viên Chính quy, khóa tuyển 2022
🔥 Tóm tắt bài báo: AutoViVQA: A Large-Scale Automatically Constructed Dataset for Vietnamese Visual Question Answering: Bài báo xây dựng AutoViVQA, một bộ dữ liệu VQA tiếng Việt quy mô lớn gồm 19.411 ảnh và 37.077 câu hỏi kết hợp từ MS COCO cùng ngữ cảnh VISTA. Khác với các phương pháp gán nhãn thủ công tốn kém hay sinh tự do dễ gây ảo giác, toàn bộ dữ liệu được tạo hoàn toàn tự động bằng LLM dưới sự định hướng của khung kiểm soát suy luận chặt chẽ. Quy trình cũng tích hợp cơ chế lọc tự động đa tiêu chí nhằm bảo đảm tính gắn kết thị giác và độ chuẩn xác ngôn ngữ. Thử nghiệm thực nghiệm chứng minh tập dữ liệu này giúp cải thiện đáng kể độ chính xác và độ ổn định của các mô hình thị giác–ngôn ngữ khi tinh chỉnh.
✨ Điểm nổi bật của bài báo: AutoViVQA: A Large-Scale Automatically Constructed Dataset for Vietnamese Visual Question Answering: Điểm nổi bật là khung sinh dữ liệu kiểm soát nhận thức theo 5 cấp độ tư duy và 9 nhóm ngữ nghĩa, giúp cân bằng giữa suy luận quan hệ, nhân quả với nhận diện thông thường thay vì thiên lệch vào câu hỏi Yes/No. Bên cạnh đó, bài báo thiết kế giao thức lọc tự động bằng ensemble nhiều mô hình trên 18 tiêu chí và bỏ phiếu đa số, đạt độ tương quan cao với người đánh giá (alpha = 0.72) mà không cần can thiệp thủ công. Cấu trúc dữ liệu chuẩn hóa gồm 5 câu trả lời ngắn tự nhiên (1–10 từ) cho mỗi câu hỏi cũng tạo nền tảng tối ưu cho việc đánh giá dựa trên sự đồng thuận.
🌈 Về Asian Conference on Intelligent Information and Database Systems: ACIIDS (rank B) là hội nghị quốc tế về Hệ thống Thông tin và Cơ sở Dữ liệu Thông minh, lần thứ 18 diễn ra vào tháng 4 năm 2026 tại Cao Hùng, Đài Loan. Sự kiện là diễn đàn uy tín quy tụ các chuyên gia toàn cầu nhằm chia sẻ nghiên cứu mới về trí tuệ nhân tạo, khoa học dữ liệu và tính toán thông minh. Các bài báo xuất sắc tại hội nghị được xuất bản trong bộ sách Lecture Notes in Artificial Intelligence (LNAI/LNCS) của Springer và chỉ mục trong Scopus, Web of Science.
🌟 Bài báo số 2: ViMoE-VQA: Reasoning-Aware Sparse Experts for Generative Vietnamese Visual Question Answering
👉 Link bài báo: https://drive.google.com/file/d/1pQfIUbKXg4R7ALeCzqNRI3M3igfKaxif/view
 Các tác giả: SV. Nguyễn Anh Tường, SV. Phan Bá Đức, SV. Nguyễn Trung Quốc, SV. Trần Đắc Thịnh, SV. Đặng Duy Lân, SV. Nguyễn Quốc Thịnh - Sinh viên Chính quy, khóa tuyển 2022
Giảng viên cùng thực hiện: TS. Lê Thanh Tùng – Giảng viên Khoa Công nghệ Thông tin, Trường Đại học Khoa học tự nhiên, ĐHQG-HCM
🔥 Tóm tắt bài báo: ViMoE-VQA: Reasoning-Aware Sparse Experts for Generative Vietnamese Visual Question Answering: Bài báo đề xuất mô hình ViMoE-VQA nhằm giải quyết hạn chế của các phương pháp hợp nhất đa phương thức dày đặc truyền thống trong bài toán VQA dạng sinh cho tiếng Việt. Kiến trúc này kết hợp hai bộ mã hóa đóng băng gồm CLIP (thị giác) và PhoBERT (tiếng Việt), sau đó đưa qua khối dung hợp Mixture-of-Experts (MoE) thưa trước khi giải mã câu trả lời tự nhiên qua một autoregressive transformer decoder. Bằng việc định tuyến các biểu diễn đặc trưng đến đúng chuyên gia phù hợp cho từng câu hỏi, mô hình vừa thích ứng tốt với các dạng suy luận phức tạp vừa tối ưu chi phí tính toán.
✨ Điểm nổi bật của bài báo: Reasoning-Aware Sparse Experts for Generative Vietnamese Visual Question Answering: Điểm nổi bật là cấu trúc 4 chuyên gia không đồng nhất (thị giác, ngôn ngữ, tương tác đa phương thức và chuyên biệt hóa cấp cao) được điều phối thông qua cơ chế định tuyến Noisy Top-2 có thành phần nhiễu ngẫu nhiên. Thiết kế này chỉ kích hoạt 50% tính toán trên mỗi token, kết hợp hàm mất mát cân bằng tải giúp đạt entropy định tuyến cao (1.2480) và triệt tiêu nguy cơ sụp đổ chuyên gia. Khi thử nghiệm trên bộ AutoViVQA, ViMoE-VQA đạt hiệu năng vượt trội và đồng đều ở hầu hết các chỉ số (F1: 60.69%, BLEU: 12.54, METEOR: 39.10), khắc phục tình trạng suy giảm độ chuẩn xác do câu trả lời lan man thường gặp ở các LLM zero-shot.
🌈 Về International Conference on Knowledge-Based and Intelligent Information & Engineering Systems: KES (rank B) là kỳ hội nghị quốc tế về Các Hệ thống Kỹ thuật & Thông tin Thông minh Dựa trên Tri thức, lần thứ 30 được tổ chức vào tháng 9 năm 2026 tại Dublin, Ireland. Hội nghị tập trung kết nối học thuật với công nghiệp ở các mảng học máy, khai phá tri thức và kỹ thuật hệ thống thông minh. Các công trình được chấp nhận sẽ xuất bản trên tạp chí Procedia Computer Science (Elsevier) dưới hình thức Open Access và được chỉ mục trong hệ thống Scopus.
🍀 Đặc biệt, hai công bố này đều thuộc đề tài tốt nghiệp “Xây dựng mô hình tạo sinh dữ liệu hỏi đáp hình ảnh tiếng Việt” đã đạt điểm 10 trong đợt bảo vệ năm 2026 và được đề xuất thành tích Nghiên cứu Khoa học - Công nghệ xuất sắc năm học 2025-2026.
🌻 Xin chúc mừng nhóm tác giả với những thành tựu nghiên cứu nổi bật này.
🌻Chúc các bạn sẽ tiếp tục đạt được thành công trong tương lai.